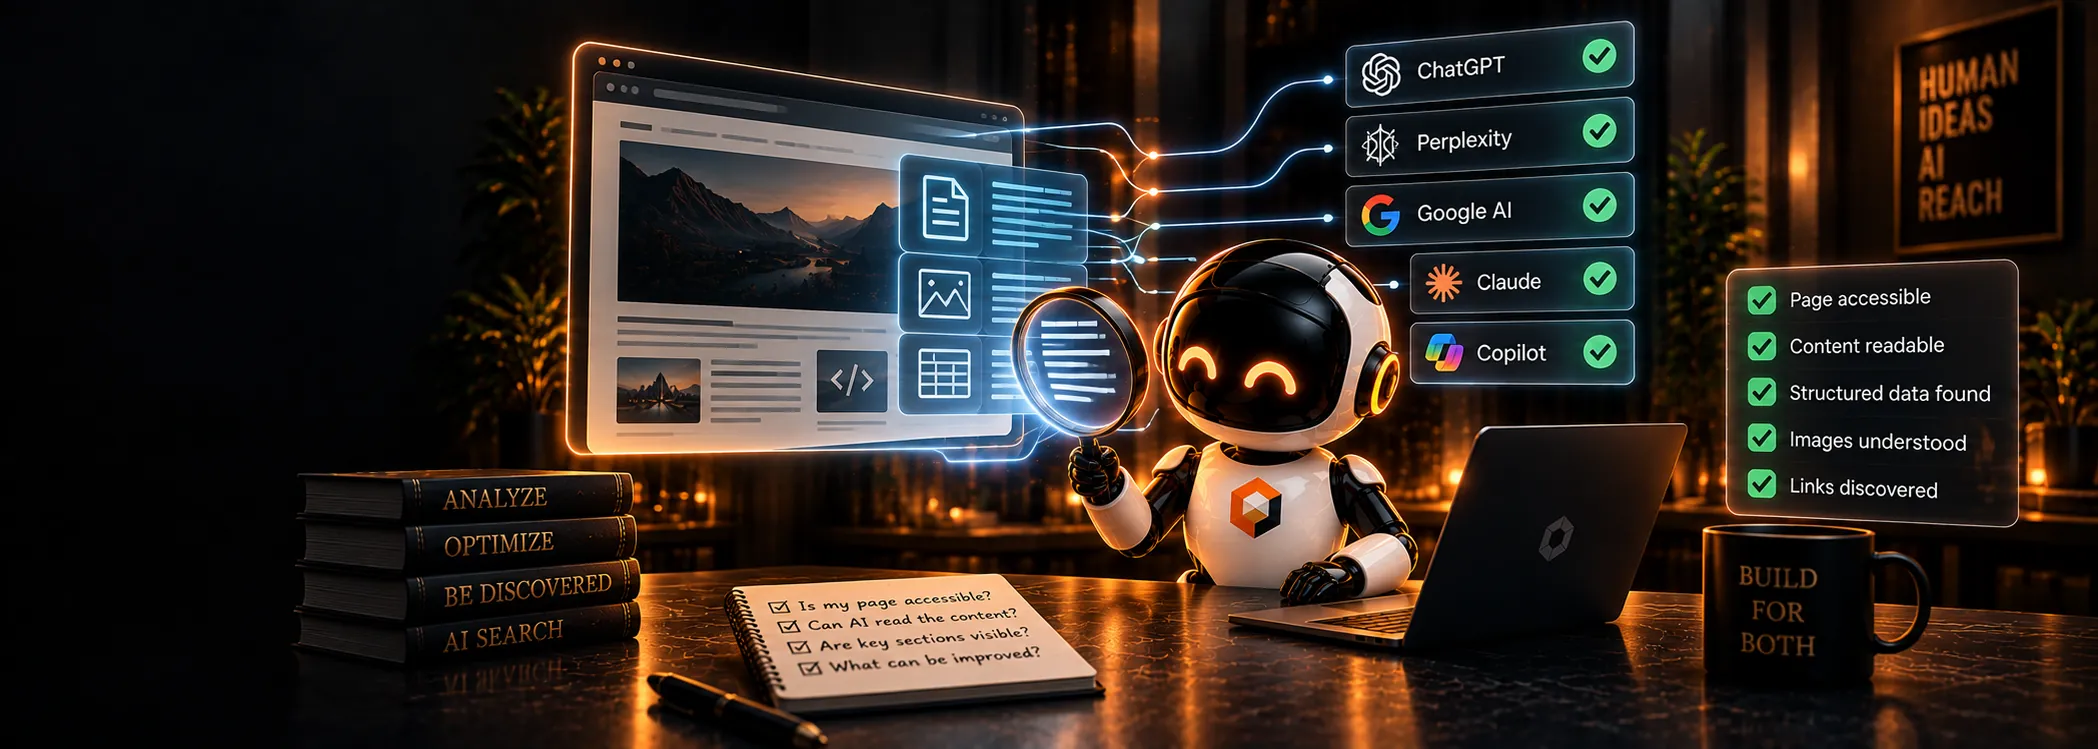
Respuesta corta: comprueba seis cosas en este orden: que robots.txt permite el acceso al rastreador del motor de respuesta, que la página devuelve un estado 200, que nada la marca como noindex, que el contenido principal está en el HTML sin procesar sin necesidad de JavaScript, que los controles de fragmentos no impiden citarla y que la página tiene encabezados claros y una respuesta directa. Si las seis pasan, la página es legible. Que la citen es otra cuestión.
¿Por qué "legible" no es lo mismo que "visible en un navegador"?
Un navegador ejecuta JavaScript, carga fuentes, espera a los scripts y te enseña la página terminada. Muchos rastreadores hacen mucho menos. Unas pruebas publicadas a finales de 2024 vieron que los principales rastreadores de IA descargaban el HTML sin procesar y no ejecutaban JavaScript. Una página que se ve perfecta en Chrome puede estar casi vacía para ellos.
Vimos una versión más sutil de esto en nuestro propio sitio. Nuestro framework enviaba en streaming el título de la página y la etiqueta canonical dentro del cuerpo del HTML para la mayoría de los visitantes, y solo los mandaba en el <head> a una lista de bots permitidos que no incluía ningún rastreador de IA. En una medición del 22 de septiembre de 2026, GPTBot recibía el <title> en el byte 29.701 de la página, después del encabezado principal. Bingbot lo recibía en el byte 1.533. Para cualquier persona, la página se veía bien. Lo arreglamos ampliando la lista de bots permitidos, y ahora el título llega también a los rastreadores de IA en el byte 1.985.
La lección: comprueba siempre lo que recibe el rastreador, no lo que ves tú.
¿Cuáles son las seis comprobaciones?
1. Acceso del rastreador
Abre yourdomain.com/robots.txt y revisa los grupos de OAI-SearchBot (búsqueda de ChatGPT), PerplexityBot, Claude-SearchBot y Googlebot. Un Disallow: / bajo User-agent: * bloquea a todos los rastreadores que no tengan su propio grupo. Nuestro comprobador gratuito lee el archivo por ti y te dice qué rastreadores de IA tienen acceso; la lista de rastreadores explica qué hace cada uno.
2. Código de estado
La página debe devolver 200. Las cadenas de redirecciones, los soft 404 y las páginas que devuelven 200 mientras muestran un mensaje de error confunden a los rastreadores. Puedes comprobarlo con curl -I https://yourdomain.com/page.
3. Indexabilidad
Busca <meta name="robots" content="noindex"> en el HTML y una cabecera de respuesta X-Robots-Tag: noindex. Comprueba que la etiqueta canonical apunta a la propia página, no a la home ni a otra URL. Una canonical equivocada les dice a los motores que ignoren la página en favor de otra.
4. Contenido en el HTML sin procesar
Descarga la página sin JavaScript y busca tu texto principal:
curl -s -A "Mozilla/5.0 (compatible; GPTBot/1.2)" https://yourdomain.com/page | less
Si en esa salida faltan el titular, el primer párrafo y los datos clave, probablemente los rastreadores de IA no pueden leerlos. La solución es el renderizado en el servidor o la generación estática para el contenido importante.
5. Controles de fragmentos
nosnippet, max-snippet:0 y data-nosnippet indican a los motores que no citen el texto. Google también los aplica a las funciones de IA de la Búsqueda. Úsalos a propósito en el texto que no quieras que se cite, no por accidente en toda una plantilla.
6. Estructura y una respuesta directa
Legible no es lo mismo que útil. Comprueba que la página tiene un único H1 claro, subtítulos descriptivos y un primer párrafo que responde a la pregunta principal de la página. Los motores extraen pasajes autónomos; una página que llega al grano en el octavo párrafo les da poco que citar.
¿Hay una forma más rápida de hacer las seis?
Sí. Nuestra comprobación gratuita de una página descarga una URL una vez y le aplica las 88 comprobaciones a nivel de página de nuestro registro de comprobaciones: estructura, schema, preparación para responder y citabilidad. Cada hallazgo muestra la evidencia, así que puedes verificarlo tú mismo. No hace falta cuenta.
Para Google en concreto, la herramienta de inspección de URLs de Search Console muestra el HTML que Google renderizó y si la página está indexada.
¿Cuál es el equivalente en SEO clásico?
Las seis comprobaciones son SEO técnico de manual: robots.txt, códigos de estado, directivas de indexación, renderizado y estructura on-page. La diferencia en la búsqueda con IA es que ahora tienes que contentar a varios rastreadores, algunos de los cuales renderizan menos que Googlebot, así que el contenido renderizado en el servidor importa más.
Preguntas frecuentes
¿Los rastreadores de IA ejecutan JavaScript?
Muchos no. Da por hecho que el contenido que solo aparece después de ejecutar JavaScript puede ser invisible para los rastreadores de IA, y renderiza el contenido importante en el servidor.
Mi página está indexada en Google. ¿ChatGPT puede leerla?
No necesariamente. La búsqueda de ChatGPT usa OAI-SearchBot y su propio índice. Comprueba que OAI-SearchBot tiene acceso y que tu contenido está en el HTML sin procesar.
¿Arreglar esto garantiza que me citen?
No. Estas comprobaciones hacen que una página sea legible. Que te citen depende además de encajar con la pregunta y de tener un pasaje citable, algo que explicamos en cómo deciden los motores de IA qué marcas citar.